Yapay Zekâ / ML · Cloud-Native
Model eğitiminden otomatik ölçeklenen, canlı bir API'ye — otomatik olarak
Bir modelin birkaç versiyonunu eğiten, en iyisini seçen ve talebe göre büyüyüp küçülen bir servis olarak yayına alan bir veri hattı. Veri bilimi ile operasyon arasında elle devir teslim yok.
Proof of concept: Kubeflow Pipelines + KServe: Kubernetes üzerinde uçtan uca MLOps
Nerede işe yarar
- Model eğitip hâlâ elle yayına alan ekipler
- Makine öğrenmesi sonuçlarını tekrarlanabilir ve denetlenebilir kılmak
- Trafiği inip çıkan modelleri servis etmek
Sayfanın devamı teknik detaylar: nasıl geliştirildiği ve sınırlarının neler olduğu.
Teknik problem
Modelleri elle eğitmek, karşılaştırmak ve yayına almak yavaş ve tekrar üretilmesi zor bir süreç. Ekiplerin eğitim çalışmasından ölçeklenebilir bir inference endpoint'ine tekrarlanabilir bir yola ihtiyacı var.
Mimari nasıl çalışıyor
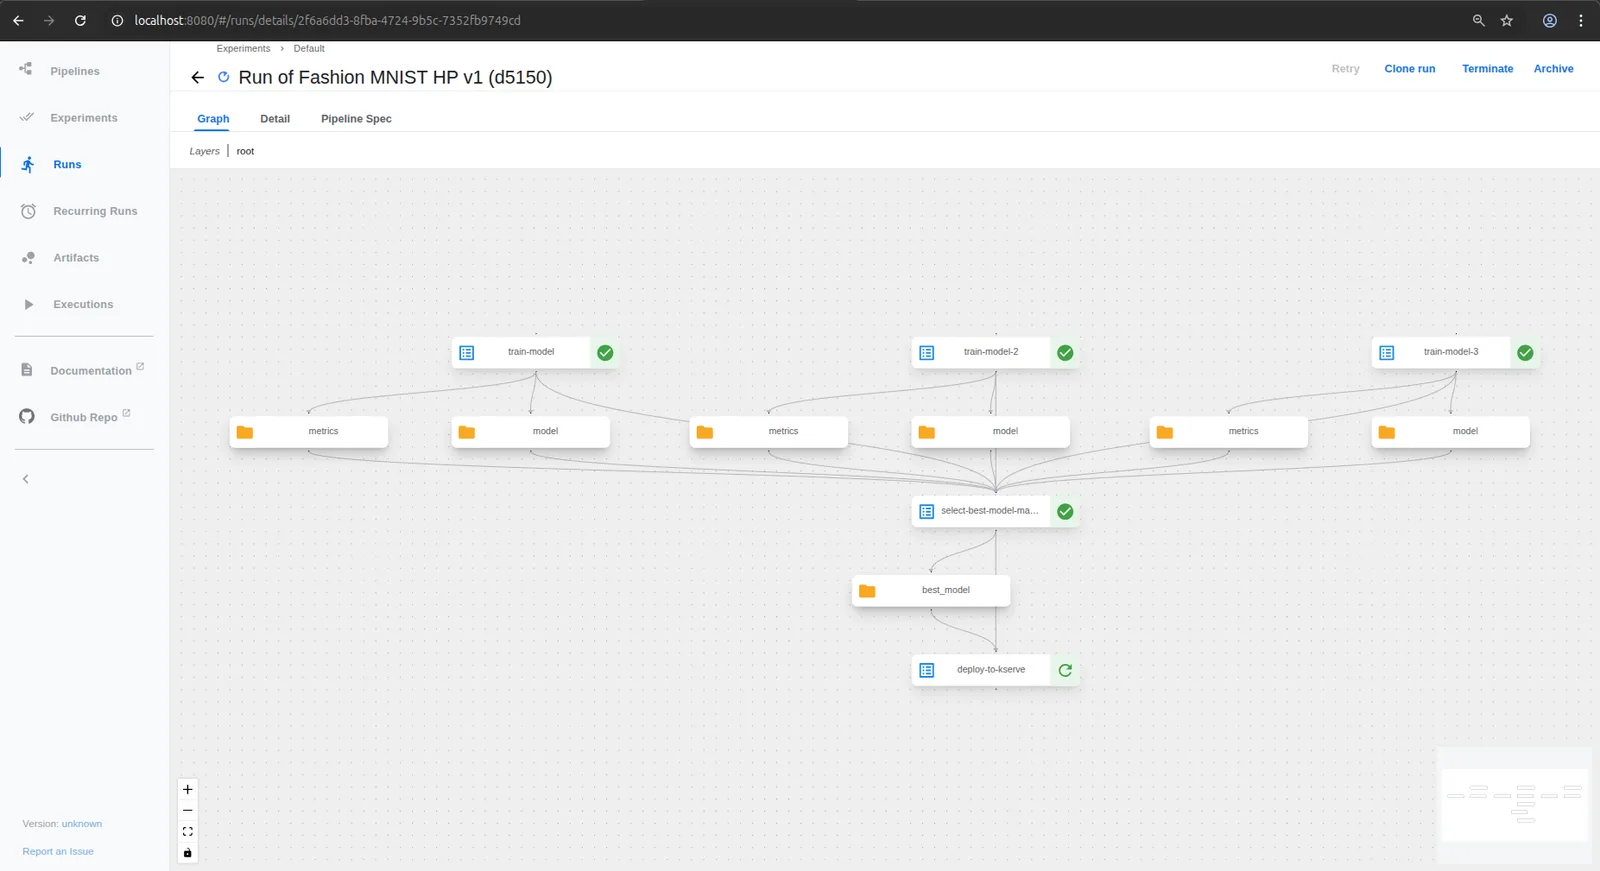
- 01 · Eğit ×3
Her learning rate için bir tane olmak üzere paralel eğitim bileşenleri (0.001, 0.0005, 0.0001).
- 02 · Seç
Bir seçim bileşeni doğrulama başarımını karşılaştırır ve en iyi modeli seçer.
- 03 · Sakla
Seçilen model MinIO'da (S3 uyumlu nesne depolama) saklanır.
- 04 · Servis et
Bir deploy bileşeni, istek yoğunluğuna göre 1 ile 3 pod arasında ölçeklenen bir KServe InferenceService oluşturur.
Neyi araştırıyorduk
Makine öğrenmesi işi klasik CI/CD varsayımlarını bozar: bir model; kod, veri, hiperparametreler ve çalışma ortamının birleşimidir. Amaç, yaşam döngüsünün tamamının — paralel eğitim, karşılaştırma, seçim ve servis — Kubernetes üzerinde tek bir tekrarlanabilir iş akışı olarak çalışabileceğini göstermekti.
Neden bu yaklaşım
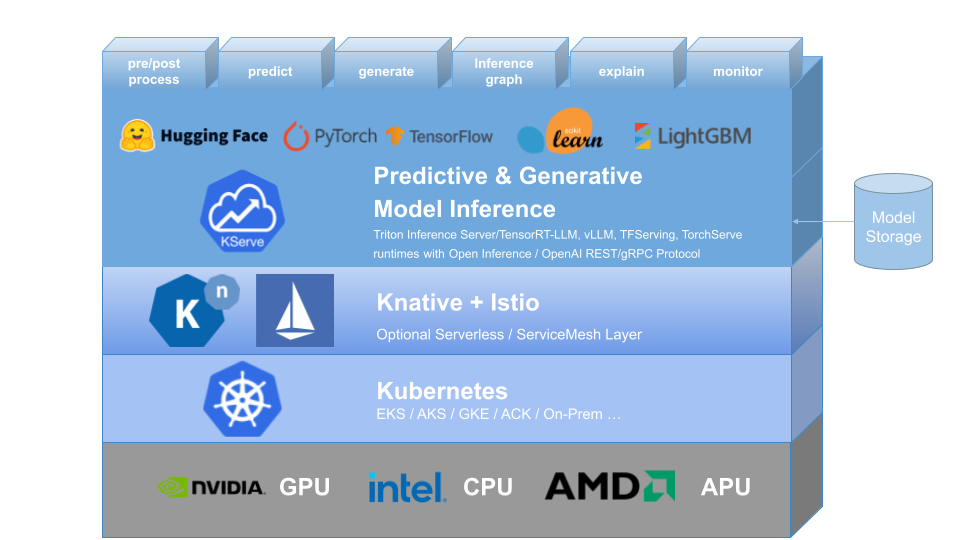
Kubeflow Pipelines, Kubernetes'in üzerine ML'e özgü orkestrasyon ekler; KServe ise saklanan bir modeli Knative ile isteğe göre ölçeklenen standart bir REST inference endpoint'ine dönüştürür. İkisini birlikte kullanmak eğitimi ve servisi aynı platformda ve aynı erişim kontrolleri altında tutar.
Neler geliştirildi
Eğitim, model seçimi ve KServe deploy için hat bileşenleri; bir eğitim container imajı; KServe RBAC ve depolama secret manifest'leri; derlenmiş bir hat manifest'i ve bir inference test script'i. Hat parametrelidir (epoch, gizli birim sayısı) ve Kubeflow arayüzünden çalıştırılır.
Ne gösteriyor
"En iyi deney"den "çalışan servis"e geçiş hattın içinde otomatikleştirilebilir; böylece elle yapılan ve hataya açık bir adım ortadan kalkar. Repo, bu geçişin ihtiyaç duyduğu RBAC ve depolama bağlantılarını belgeliyor — bu tür kurulumlar genellikle tam da burada başarısız olur.
Sınırlamalar ve sonraki adımlar
- Fashion-MNIST örnek veri setini kullanır; model kalitesini değil iş akışını gösterir.
- Hiperparametre araması bir tuning servisi değil, sabit bir learning rate ızgarasıdır.
- Demo depolama bilgileri düz Kubernetes manifest'leri olarak verilmiştir; gerçek ortamlarda bir secret yöneticisiyle değiştirilmelidir.
İlgili yazılar
From Reproducible Pipelines to Auto-Scaled Inference: ML on Kubernetes with Kubeflow and KServe
Makine öğrenmesinin kendi operasyon katmanına ihtiyacı var. Makale, Kubernetes üzerinde Kubeflow Pipelines ve KServe ile paralel eğitimin, model seçiminin ve otomatik ölçeklenen servisin nasıl orkestre edildiğini anlatıyor.