Cloud-Native · Veri Mühendisliği
Sadece CPU'ya göre değil, bekleyen işe göre ölçeklenin
Arka plan işçileri, kuyrukta mesajlar biriktiğinde otomatik olarak kapasite ekler; ortalık sakinken para tasarrufu için küçülür.
Proof of concept: KEDA ile olay güdümlü otomatik ölçekleme
Nerede işe yarar
- Arka plan işleri ve kuyruk işleme
- Boşta duran sunucuların maliyetini düşürmek
- Trafik ani yükselişlerini kimse müdahale etmeden karşılamak
Sayfanın devamı teknik detaylar: nasıl geliştirildiği ve sınırlarının neler olduğu.
Teknik problem
Kuyruk güdümlü iş yükleri ya boşta bekler ya da geride kalır; çünkü CPU ve bellek ne kadar iş beklediğini göstermek için zayıf sinyallerdir.
Mimari nasıl çalışıyor
- 01 · Üret
Bir producer SQS'e ya da Kafka'ya rastgele mesajlar gönderir.
- 02 · Ölç
KEDA scaler'ları kuyruk boyutunu, Kafka gecikmesini ya da CPU kullanımını izler.
- 03 · Ölçekle
ScaledObject'ler consumer replika sayısını ayarlar; AWS erişimi için TriggerAuthentication kullanılır.
Neyi araştırıyorduk
Kubernetes otomatik ölçeklemesinin kaynak metriklerinden "bekleyen mesaj" gibi iş sinyallerine ne kadar taşınabileceğini ve aynı consumer'ın farklı tetikleyicilerle nasıl ölçeklenebileceğini.
Neler geliştirildi
Poetry ile container'laştırılmış producer ve consumer kodu, deployment ve config map'ler, üç ScaledObject çeşidi (SQS, Kafka, CPU) ve SQS için gereken trigger authentication.
Sınırlamalar ve sonraki adımlar
- Belirli bir iş yükü için ince ayarı değil, ölçekleme davranışını gösterir.
- AWS kimlik bilgileri Kubernetes secret'ı olarak verilir; EKS'te service account'lar için IAM rolleri tercih edilmelidir.
İlgili yazılar
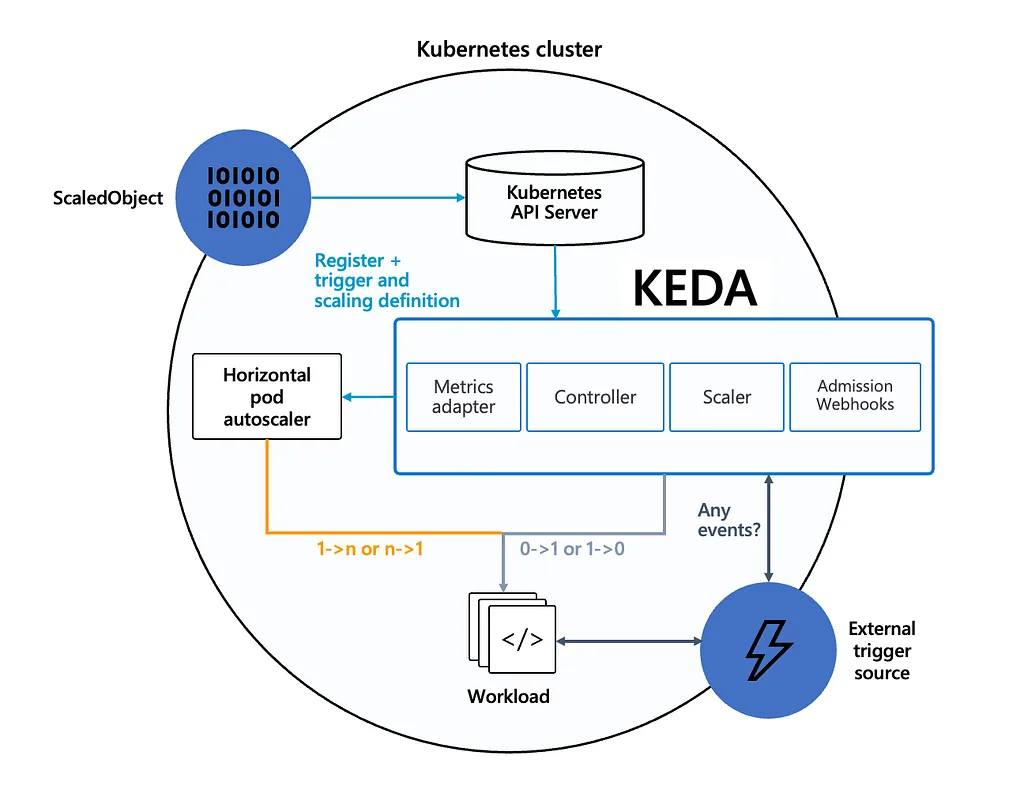
Event-Driven Autoscaling with KEDA: Scaling Kubernetes Applications in Real Time with AWS SQS, Kafka, and CPU Metrics
CPU ve bellek yanlış sinyal olduğunda: SQS ve Kafka'da kuyruk derinliğine ve CPU yüküne göre consumer'ları KEDA scaled object'leriyle ölçeklemek.